专栏

结构化长文、机制拆解和交互式文章。

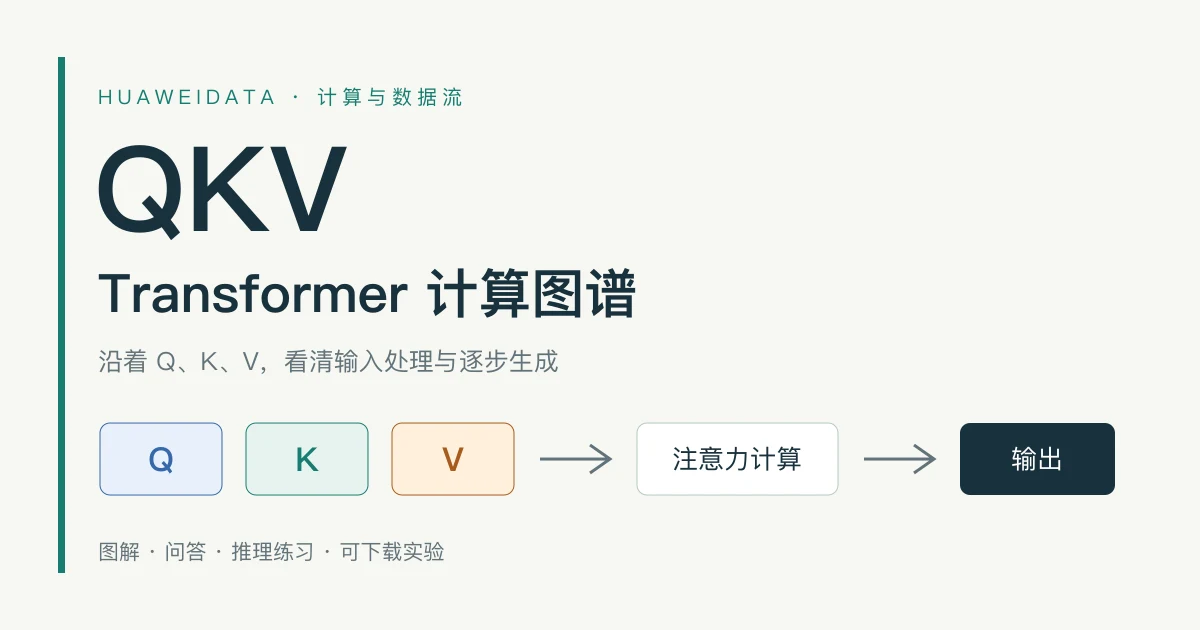
  1. Q、K、V 汇入注意力计算,K/V 中间结果保存并复用于后续生成
    QKV:Transformer 计算图谱

    QKV:Transformer 计算图谱。借助 KV 缓存,沿着 Q、K、V,看清 Transformer 从处理输入到生成回答的计算与数据流向:哪些结果已经算过,怎样保存和复用,哪些步骤可以并行,哪些必须等待。结合图解、实例与推理题,理解缓存与推理优化背后的计算机制、收益和代价。

    阅读
  2. K3 架构图解
    K3 架构图解

    从同一个 token 出发,理解 K3 的专家、注意力和深度信息:完整章节、静态机制图、公式推导、数值示例与成本取舍。

    阅读
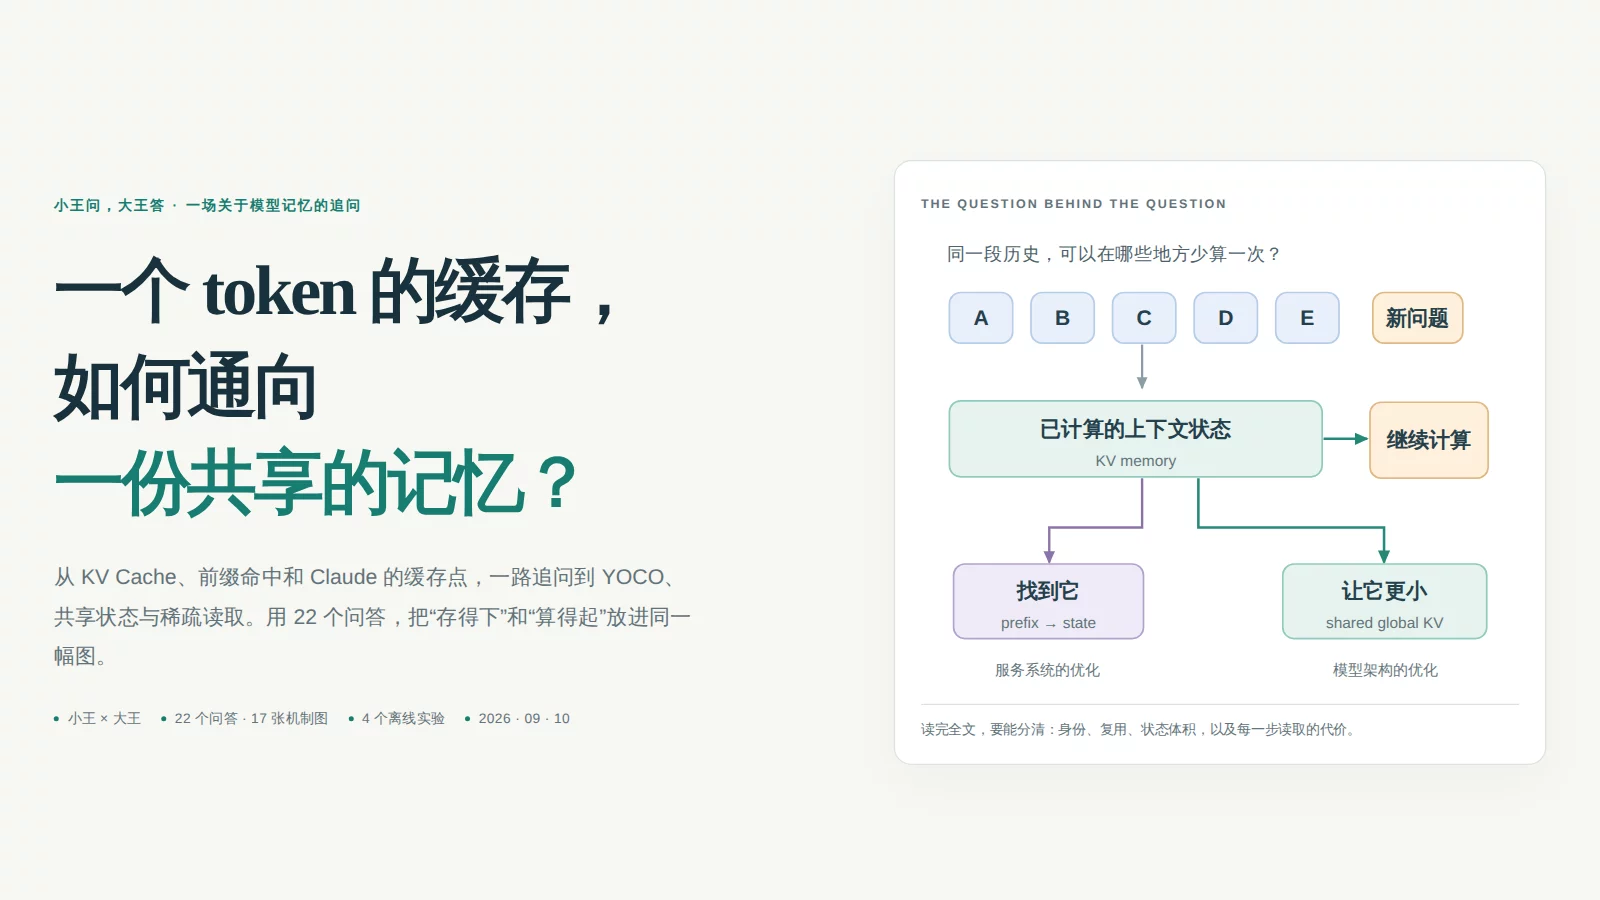
  3. 从一个 token 的缓存到共享记忆的文章首屏:左侧是标题“一个 token 的缓存,如何通向一份共享的记忆?”,右侧是输入历史、找回状态与共享全局 KV 的示意图
    小王问,大王答:从 KV Cache 到 YOCO 与共享记忆

    小王与大王的22个问答:图解KV Cache、链式hash、Claude缓存边界、DeepSeek持久化、YOCO共享记忆、890字节条件账本、近似恢复、稀疏检索与Engram。17张机制图、4个离线交互实验。

    阅读
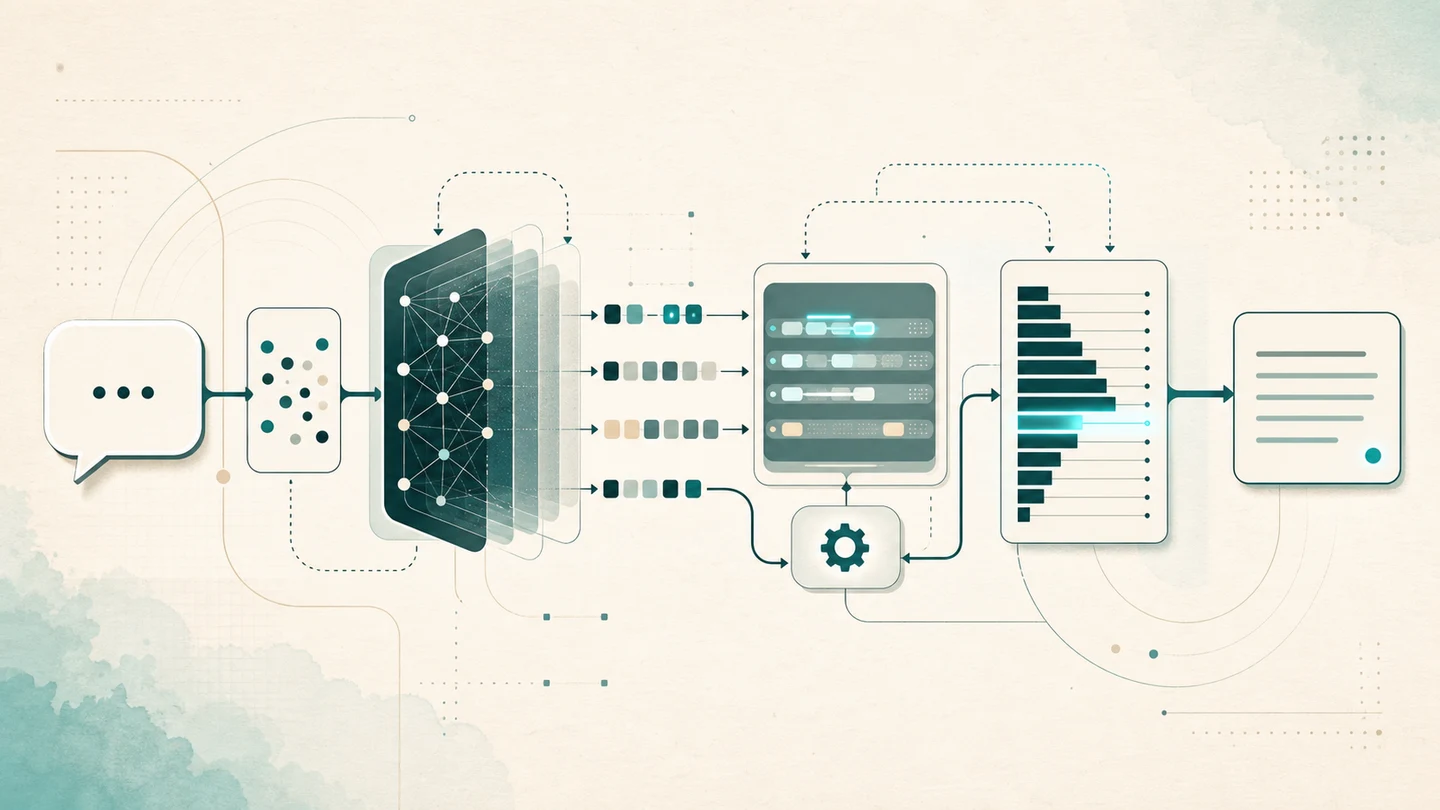
  4. 问题进入 LLM 后穿过 token、上下文、工具调用和采样流程并生成输出的技术流程图
    一个问题的旅程 · LLM 从输入到输出

    从一次提问到首 token、工具调用、采样、上下文和推理预算的机制时间轴。

    阅读